Arm-wise Compositional Generalization in Dual-Arm Vision-Language-Action Models
arXiv 2026
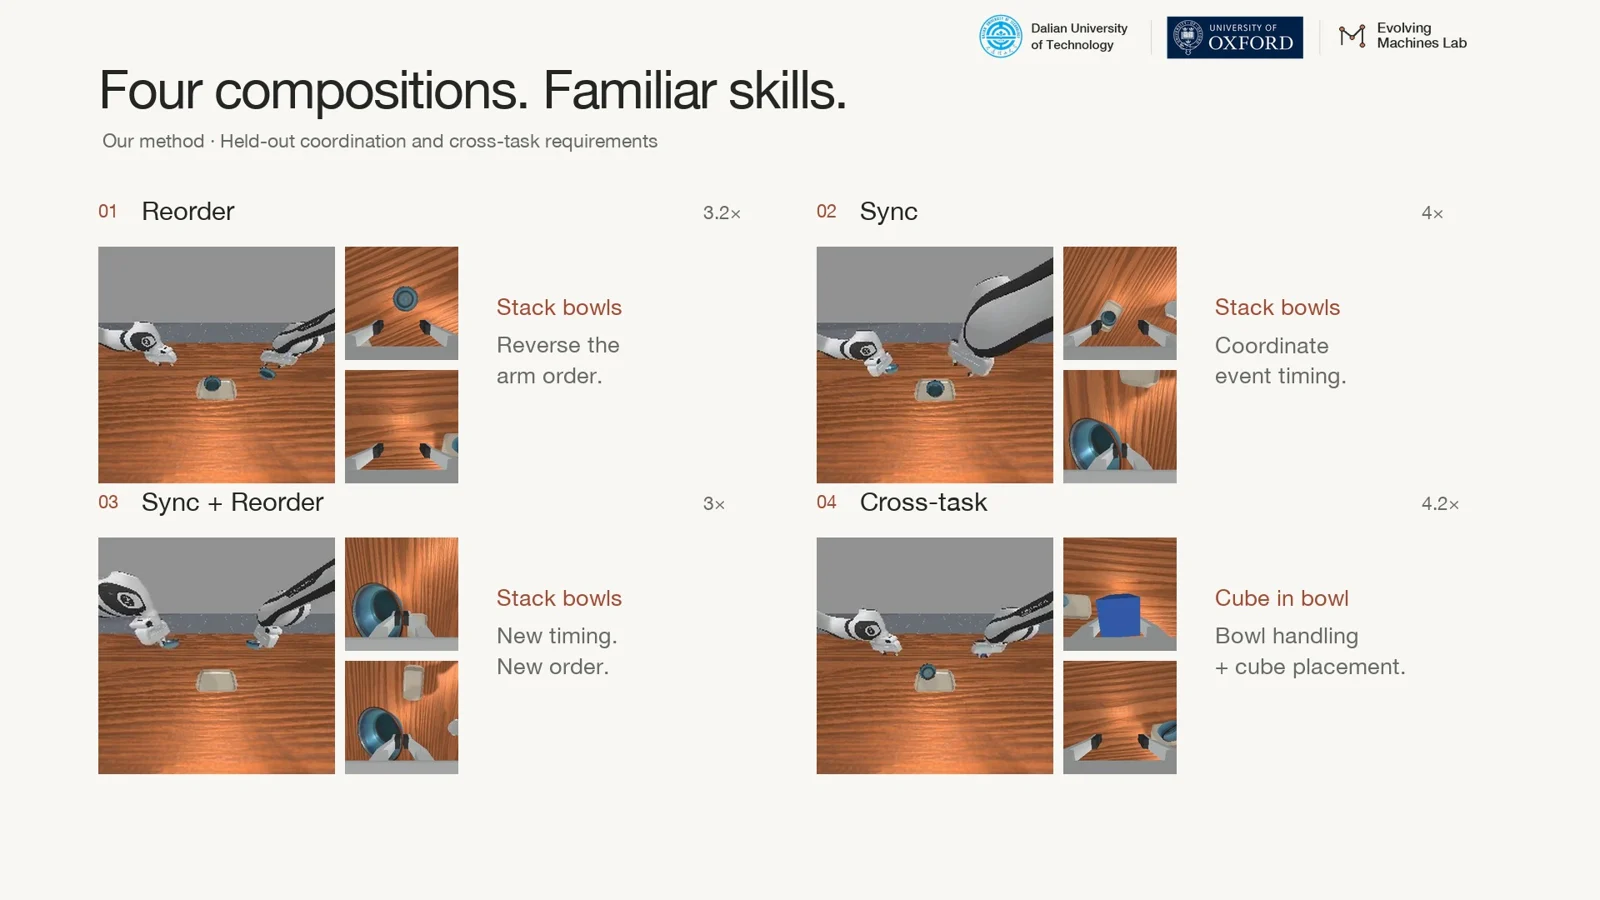
ACG-Bench tests whether dual-arm robots can reuse familiar skills under unseen orders, timing constraints, and cross-task compositions. AE-VLA combines arm-token grouping, skill-specific LoRA adapters, and arm-wise attention in a shared vision-language-action policy. It reaches 21.53% success across 17 unseen simulation conditions and 39.00% across five unseen conditions on physical SO101 robots, advancing compositional skill reuse within the Future ecosystem.


